
El 25 de octubre, Diario de Jerez nos dedicó un reportaje de María Valero sobre nuestro trabajo y Sherry 0.1. Ver nuestro trabajo en el periódico de nuestra ciudad nos hace especial ilusión. Acerca a nuestros vecinos una parte de lo que hacemos que suele quedarse entre repositorios, servidores y conversaciones técnicas: investigar cómo funcionan los modelos de inteligencia artificial y cómo podemos mejorarlos.
Sherry nace de esa curiosidad, con una pregunta muy concreta: ¿podemos dar a una aplicación más control sobre el esfuerzo que dedica un modelo a cada respuesta? Para responderla, combinamos matemáticas, datos e infraestructura. Así entendemos también nuestro trabajo en Valendra. Queremos construir una empresa en la que resolver problemas para nuestros clientes, desarrollar productos e investigar se alimenten mutuamente. La noticia es una buena ocasión para contar esa historia con algo más de detalle.
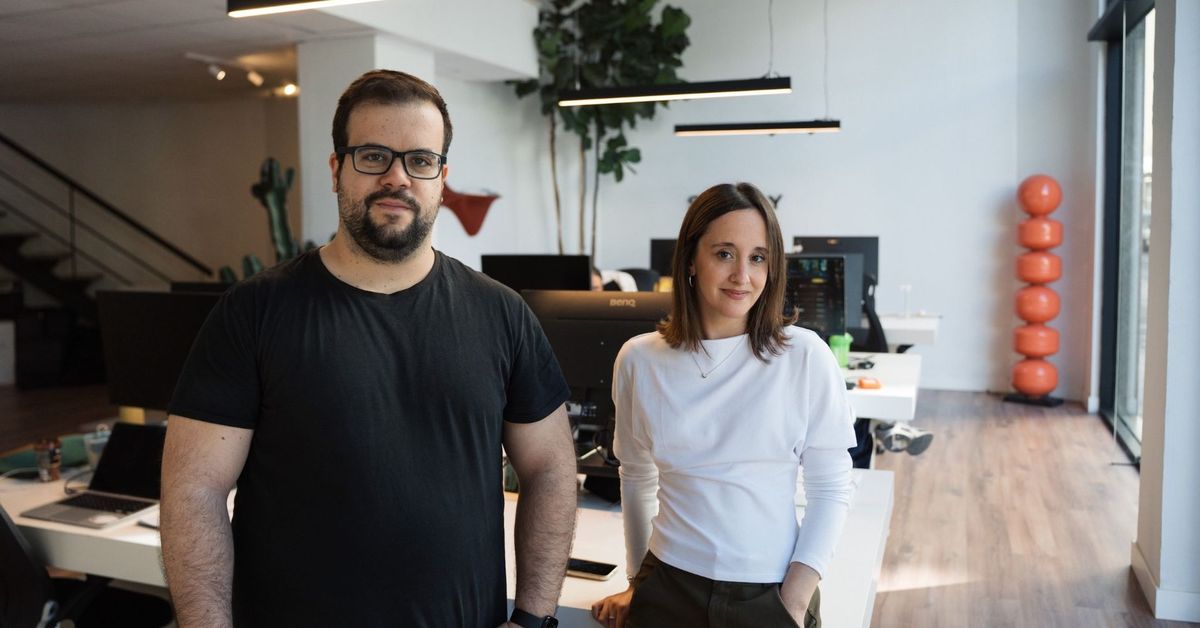
En Valendra unimos nuestras disciplinas para resolver problemas
Somos una consultora e ingeniería tecnológica con sede en Jerez de la Frontera. Trabajamos en cloud, datos, inteligencia artificial y desarrollo de software. En cada área nos interesa la misma cuestión: entender qué está frenando a una organización y diseñar una solución que su equipo pueda operar, mantener y hacer evolucionar.
Unimos nuestras trayectorias en matemáticas, infraestructura, sistemas distribuidos y aprendizaje automático. Venimos de disciplinas distintas y hemos aprendido a aprovechar esa mezcla: contrastamos el razonamiento con los datos y revisamos qué necesita una solución para funcionar en la práctica.
En el trabajo diario, esa mezcla se traduce en preguntas prácticas. Si un sistema va lento, necesitamos saber dónde se consume el tiempo. Si una automatización comete errores, hay que revisar los datos y el proceso antes de añadir complejidad. Si una empresa quiere incorporar IA, debemos acordar qué resultado considera válido y cómo se comprobará. Puedes conocernos mejor en nuestra página de equipo.
Con Sherry queremos dar más control sobre el esfuerzo de razonamiento
Con Sherry investigamos cómo hacer configurable el razonamiento de un modelo. Partimos de Qwen3.6-35B-A3B, una arquitectura de mezcla de expertos, o Mixture of Experts. Sus aproximadamente 35.000 millones de parámetros representan el tamaño total, de los que unos 3.000 millones se activan por token. Esa activación parcial permite repartir el cálculo entre expertos. La memoria y la infraestructura necesarias siguen dependiendo del modelo completo y de cómo se despliegue.
Nuestra investigación se centra en orientar cuánto razona el modelo. En nuestra versión SFT introdujimos tres controles, low, medium y high, mediante tokens específicos. Estos niveles influyen en la profundidad de la generación, pero no fijan un tiempo de respuesta ni garantizan el acierto.
Pensemos en una aplicación que recibe tareas de distinta dificultad. Clasificar una petición sencilla puede justificar una respuesta breve. Revisar una función con casos límite puede requerir más pasos. Resolver una cuestión técnica con varias restricciones puede necesitar una exploración mayor. Poder elegir el esfuerzo permite estudiar esas diferencias dentro de un mismo sistema.
Es una decisión con consecuencias visibles para quien usa la aplicación. Cada generación ocupa tiempo y capacidad de servicio. Cuando el razonamiento adicional mejora la respuesta, ese coste puede estar justificado. Cuando solo alarga una solución que ya era suficiente, introduce una espera que conviene medir. Esa relación entre calidad y recursos es el centro de la pregunta que estamos investigando.
Entrenamos con ejemplos verificados y aprendizaje por refuerzo
Partimos de un modelo ya entrenado y adaptamos su comportamiento hacia un objetivo específico. En nuestro dataset público de Sherry publicamos 2.061 ejemplos de razonamiento matemático con respuestas verificadas. Etiquetamos las trazas según su profundidad observada: más corta, intermedia o más larga.
En la primera fase utilizamos ajuste supervisado, conocido como SFT, para enseñar la relación entre esas etiquetas y la forma de responder. En la segunda aplicamos GRPO, un método de aprendizaje por refuerzo que compara varias generaciones. En nuestra explicación técnica del entrenamiento detallamos cómo damos el mayor peso a la corrección, junto con señales sobre la estructura de la respuesta y su longitud según el esfuerzo elegido.
El diseño de esa recompensa importa. Una respuesta breve que falla no resuelve el problema. Una explicación extensa que termina mal tampoco. La evaluación debe comprobar qué cambia en la respuesta, cuánto cuesta obtenerla y dónde deja de ser útil el ajuste. Documentamos esas decisiones para que otras personas puedan entender qué hemos probado y proponernos evaluaciones distintas.
Publicamos nuestros resultados para que puedas contrastarlos
En nuestra ficha de Sherry en Hugging Face publicamos esta comparación con el modelo base. Utilizamos el mismo entorno de evaluación y Sherry en esfuerzo alto:
| Prueba y métrica | Modelo base | Sherry 0.1 |
|---|---|---|
MATH-500 · math_verify | 88,3 % | 97,1 % |
| GPQA-Diamond · coincidencia exacta | 57,1 % | 78,3 % |
Python básico · pass@1, 40 tareas | 75,0 % | 97,5 % |
En GPQA-Diamond, la media de tokens de salida pasó de unos 20.000 a 7.500. Obtuvimos estos resultados en nuestra evaluación controlada, con un alcance concreto. También documentamos el posible solapamiento entre datos de entrenamiento y pruebas matemáticas. Seguimos revisando la comparación de AIME 2025.
Para nosotros, publicar estos resultados tiene sentido si permite examinarlos. Una cifra necesita su protocolo, sus condiciones y sus límites para resultar útil. Quien quiera probar Sherry puede consultar las fichas, comparar con el modelo base y evaluar problemas representativos de su propia aplicación. Ahí empieza la conversación técnica que queremos abrir.
Conectamos lo que investigamos con lo que construimos para nuestros clientes
Nuestros proyectos para clientes nos acercan a restricciones muy concretas: presupuestos, plazos, sistemas que ya existen y equipos que tendrán que mantener lo que construyamos. Investigar ayuda a examinar con más profundidad las herramientas que podemos emplear en ese contexto. Esa relación funciona cuando el aprendizaje se convierte en decisiones mejor explicadas y resultados que se pueden comprobar.
En ingeniería de inteligencia artificial, por ejemplo, la elección del modelo es una parte del trabajo. También hay que preparar los datos, integrar el sistema, definir cómo se revisarán sus respuestas y observar lo que ocurre después del despliegue. La experiencia de investigar un comportamiento concreto ayuda a formular mejores preguntas sobre esas capas.
Con QDivZero trabajamos en otra parte de ese recorrido: el despliegue y la operación de modelos. Hemos contado también nuestra incorporación a NVIDIA Inception con QDivZero. Sherry y QDivZero tienen objetivos propios, pero ambos nos llevan a trabajar sobre cómo hacer que la IA sea más comprensible y manejable para los equipos que la utilizan.
Llevamos nuestra ciudad en el nombre y compartimos lo que aprendemos
Llamarlo Sherry es una manera de llevar nuestra ciudad al proyecto. Con su imagen hacemos también un guiño a Fino Caballito, otro emblema de Jerez. El caballo, la copa de fino y el portátil reúnen esa referencia local con el trabajo tecnológico que hacemos. Nos hace ilusión que alguien encuentre el modelo, sienta curiosidad por él y descubra que lo estamos desarrollando desde aquí.
También queremos que esa curiosidad tenga un espacio cerca. Con SherryNets participamos en una comunidad alrededor de programación, datos e infraestructura. Compartir una duda, explicar un experimento o escuchar cómo aborda otra persona un problema son formas de hacer que el conocimiento circule.
Gracias a María Valero y a Diario de Jerez por acercarse a conocernos. La mejor manera de aprovechar esta noticia es seguir construyendo trabajo que merezca explicarse: proyectos útiles, investigación que se pueda contrastar y oportunidades para aprender con otras personas desde Jerez.
Puedes empezar por el reportaje original, explorar Sherry en Hugging Face o hablar con nuestro equipo sobre un problema de datos, infraestructura o IA que estés intentando resolver.